Le budget de crawl est le volume de pages que Google accepte d’explorer sur votre site sur une période donnée. Pour la grande majorité des sites de TPE, de PME et d’artisans, ce n’est pas lui qui bloque vos demandes de devis.
En revanche, les erreurs qui gaspillent ce budget (pages en double, redirections en chaîne, serveur lent) coûtent des positions à tous les sites, petits ou grands. Voici comment savoir si vous êtes concerné, quoi vérifier et quoi corriger en priorité.
En bref
- Le budget de crawl (ou budget d’exploration) correspond aux URL que Google peut et veut explorer sur votre site. Une URL est simplement l’adresse d’une page.
- Selon Google, il concerne surtout les sites de plus d’un million de pages, ou de plus de 10 000 pages mises à jour chaque jour. Un site vitrine d’artisan en est très loin.
- Votre vrai sujet : que vos pages de services et de zones, celles qui génèrent des appels, soient explorées, indexées puis bien positionnées.
- Cinq contrôles dans la Search Console et quelques corrections techniques suffisent dans 90 % des cas à lever les blocages.
Le budget de crawl, expliqué simplement
Google utilise un robot, appelé Googlebot, qui visite les pages des sites pour les découvrir et les mettre à jour. Cette visite s’appelle le crawl, ou l’exploration.
Le robot ne dispose pas d’un temps illimité pour chaque site. Il visite ce qu’il juge utile, à un rythme que votre serveur peut supporter.
Le budget de crawl, c’est donc la quantité de pages que Google peut et veut explorer chez vous. Selon la documentation officielle de Google, il dépend de deux éléments que nous détaillons ci-dessous.
Pourquoi cela vous concerne en tant que dirigeant ? Parce qu’une page non explorée ne peut pas être indexée. Et une page non indexée n’apparaît pas dans Google, donc ne fait sonner aucun téléphone.
Une précision utile sur le mot « site »
Pour Google, un site correspond à un nom d’hôte unique. Selon cette même documentation, www.exemple.fr et un sous-domaine comme blog.exemple.fr sont traités comme deux sites distincts, avec chacun leur budget d’exploration.
Si vous avez séparé votre boutique, votre blog ou votre espace client sur des sous-domaines, chacun est donc évalué séparément.
Les deux éléments qui déterminent votre budget
Le budget d’exploration repose sur deux mécanismes, qui se cumulent.
La capacité d’exploration de votre serveur
Google ne veut pas faire tomber votre site. Il adapte donc le nombre de connexions simultanées et le temps d’attente entre deux requêtes à la santé de votre serveur. Gary Illyes, de l’équipe Google, l’explique : cette limite monte ou descend selon la réactivité du site et le réglage défini dans la Search Console.
Concrètement, un hébergement lent ou instable freine le robot. Un serveur qui répond vite lui permet d’en voir plus.
Le besoin d’exploration de Google
Même si votre serveur tient la charge, Google n’explore pas tout, tout le temps. Le besoin d’exploration varie selon la taille du site, la fréquence des mises à jour, la qualité des pages et leur pertinence. D’après la documentation Google, si ce besoin est faible, l’exploration reste réduite même quand la capacité n’est pas atteinte.
Trois leviers sont à votre portée :
- L’inventaire perçu : l’ensemble des URL que Google pense devoir explorer. C’est le plus facile à contrôler.
- La popularité : les pages recevant des liens, internes comme externes, sont explorées plus souvent.
- La fraîcheur : un contenu régulièrement mis à jour donne des raisons de revenir.
Votre site est-il concerné ?
La réponse honnête tient en une ligne : probablement pas au sens strict. Google distingue trois profils dans son guide de gestion du budget d’exploration.
| Profil de site | Repère indiqué par Google |
|---|---|
| Très gros site à contenu changeant | Plus d’un million de pages uniques, mises à jour environ une fois par semaine |
| Site moyen à grand, très dynamique | Plus de 10 000 pages uniques, mises à jour quotidiennement |
| Site avec beaucoup d’URL non indexées | Une part importante d’URL classées « Détectée, actuellement non indexée » dans la Search Console |
Google précise que ces chiffres sont une approximation générale, pas des seuils exacts.
Où se situe un site d’artisan ou de PME ?
Un site de couvreur, de plombier, de paysagiste ou de pisciniste compte généralement quelques dizaines de pages, rarement plus de quelques centaines. Même un catalogue e-commerce de taille moyenne reste loin du million.
Le budget de crawl n’est donc pas votre premier chantier. Votre premier chantier, c’est que chaque page utile soit découverte, comprise et jugée digne d’être indexée.
Le seul signal d’alerte à surveiller
Si, dans la Search Console, beaucoup de vos pages apparaissent en « Détectée, actuellement non indexée », Google les a repérées mais n’est pas allé les explorer. Ce n’est pas anodin : ces pages ne vous apportent aucune demande.
Ce cas touche parfois des sites moyens, notamment ceux qui génèrent automatiquement des centaines de pages par ville, par produit ou par filtre.
Explorer n’est pas indexer : la distinction qui change tout
Beaucoup de dirigeants pensent qu’une page visitée par Google est une page visible. C’est faux.
Selon Google, toutes les pages explorées ne sont pas nécessairement indexées. Après l’exploration, chaque page est évaluée, consolidée avec d’éventuels doublons, puis examinée pour savoir si elle mérite d’entrer dans l’index, la grande base de données où Google range les pages qu’il peut afficher.
En pratique, vous pouvez rencontrer trois situations :
- Page non explorée : Google ne l’a pas vue (page orpheline, bloquée, trop profonde).
- Page explorée mais non indexée : Google l’a lue et l’a jugée peu utile, trop proche d’une autre ou de faible qualité.
- Page indexée : elle peut apparaître dans les résultats.
Pour un artisan, le deuxième cas est le plus fréquent. Une page « Couvreur à Rouen » copiée-collée en « Couvreur à Elbeuf » avec seulement le nom de la ville changé ne sera pas retenue. Le problème est la qualité, pas le budget.
Comment vérifier ce que Google explore sur votre site
Tout se passe dans la Search Console, l’outil gratuit de Google qui montre comment votre site est vu dans les résultats. Si vous ne l’avez pas encore configurée, notre guide complet de la Google Search Console vous guide pas à pas.
Le rapport « Statistiques sur l’exploration »
Ce rapport se trouve dans les paramètres de la Search Console. D’après l’aide officielle de Google, il indique le total des demandes d’exploration, la taille des téléchargements, le temps de réponse moyen, l’état de l’hôte, les codes de réponse, les types de fichiers et le type de Googlebot.
Google précise toutefois qu’il s’adresse aux utilisateurs avancés et qu’il n’est probablement d’aucune utilité pour un site de moins de 1 000 pages.
Un conseil de bon sens : consultez-le une fois, sans vous y perdre. Trois lignes vous suffisent.
- Le temps de réponse moyen : s’il grimpe de façon durable, votre hébergement ralentit le robot.
- Les codes 5xx : ce sont des erreurs serveur. Ils déclenchent des alertes de disponibilité et doivent être corrigés.
- Les problèmes de robots.txt et de DNS : si Google n’arrive pas à lire votre fichier robots.txt ou à joindre votre serveur, des explorations échouent.
Le rapport « Indexation des pages »
C’est celui qui compte le plus pour vous. Il liste vos pages indexées et, surtout, les raisons pour lesquelles d’autres ne le sont pas.
Regardez en priorité :
- si vos pages de services et de zones d’intervention sont bien indexées ;
- la part de pages « Détectée, actuellement non indexée » ;
- les pages exclues pour cause de doublon ou de redirection.
Le test le plus simple
Tapez dans Google : site:votresite.fr suivi du nom d’un de vos services. Si votre page « Installation de pompe à chaleur » n’apparaît pas, vous tenez peut-être un problème d’exploration ou d’indexation. Vérifiez-la ensuite avec l’outil d’inspection d’URL de la Search Console.
Ce qui gaspille l’exploration de Google
Google le dit clairement : toute URL explorée compte généralement dans le budget. D’après sa page « Myths and facts about crawling », cela inclut les URL alternatives et les ressources embarquées comme le CSS ou le JavaScript, qui peuvent aussi consommer du budget.
Voici les sources de gaspillage les plus courantes sur les sites de PME.
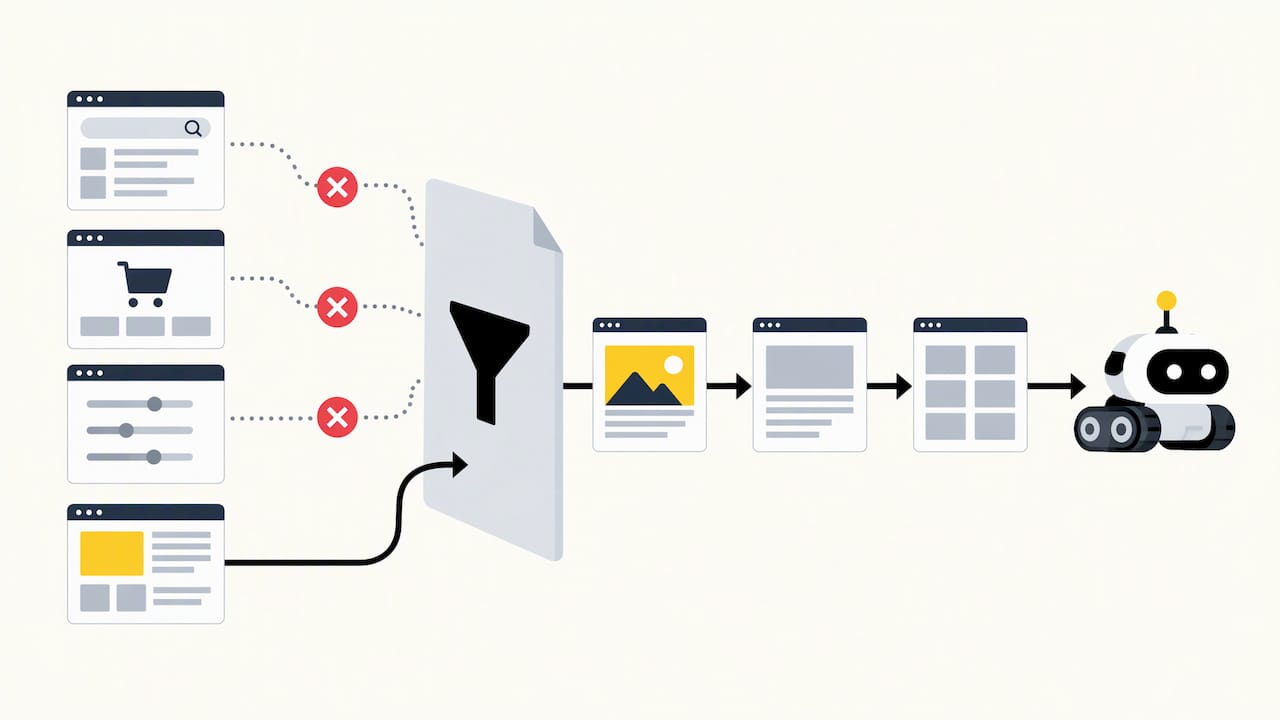
- Les URL générées par des filtres ou des paramètres : tri par prix, par couleur, par date. Une seule page peut produire des centaines d’adresses différentes.
- Les pages en double : même contenu accessible avec et sans « www », en http et en https, ou avec une barre oblique finale.
- Les pages supprimées qui renvoient une fausse réponse : une page disparue qui affiche « introuvable » tout en répondant « OK » est une erreur soft 404.
- Les chaînes de redirections : A renvoie vers B, qui renvoie vers C, qui renvoie vers D.
- Les pages orphelines et trop profondes : aucune page ne pointe vers elles, ou il faut cinq clics pour les atteindre.
- Les sitemaps obsolètes : un sitemap est la liste des pages que vous souhaitez voir explorer. S’il contient des pages supprimées, il envoie de faux signaux.
Les actions concrètes pour optimiser l’exploration
Les bonnes pratiques ci-dessous reprennent celles de Google, traduites en actions de gérant.
1. Faire le ménage dans les URL
Supprimez ou regroupez les pages qui disent la même chose. Si deux pages ciblent « plombier chauffagiste », conservez la meilleure et redirigez l’autre.
Résultat : Google concentre son attention, et vos signaux de qualité ne se diluent plus.
2. Bloquer ce qui n’a aucun intérêt pour le référencement
Le fichier robots.txt est un petit fichier qui indique aux robots les zones à ne pas explorer. Google recommande de l’utiliser pour bloquer les URL sans importance (résultats de recherche interne, paniers, filtres inutiles), et non la balise noindex, qui oblige le robot à visiter la page pour constater l’interdiction.
Attention : une erreur dans ce fichier peut bloquer tout votre site. Faites-le relire par un spécialiste avant publication.
3. Répondre correctement quand une page disparaît
Pour une page supprimée définitivement, le serveur doit renvoyer un code 404 ou 410. Cela signale clairement à Google qu’il n’y a plus rien à explorer. Corrigez aussi les erreurs soft 404 dans la Search Console.
4. Raccourcir les redirections
Une redirection doit mener directement à la page finale. Après une refonte de site, c’est l’oubli le plus fréquent : les anciennes adresses passent par deux ou trois étapes avant d’arriver à destination.
5. Tenir le sitemap à jour
Votre sitemap ne doit contenir que des pages utiles, qui répondent normalement et que vous voulez voir indexées. Mettez-le à jour à chaque ajout ou suppression de page. Sur la plupart des sites WordPress, un module le génère automatiquement.
6. Renforcer le maillage interne
Le maillage interne, ce sont les liens entre vos propres pages. Ils guident Google vers vos pages stratégiques et lui indiquent leur importance. Une page « Rénovation de toiture » liée depuis l’accueil, le menu et vos réalisations sera explorée plus souvent qu’une page isolée.
Nous détaillons la méthode dans notre guide sur le maillage interne SEO pour professionnels et dans notre article sur la stratégie de maillage interne.
7. Soigner la pagination
Si votre site affiche des listes sur plusieurs pages (réalisations, produits, actualités), la pagination doit rester claire pour le robot. Notre checklist pagination SEO reprend les bonnes pratiques.
Vitesse du site et santé du serveur : le levier le plus rentable
Selon la page de Google sur les mythes de l’exploration, un site rapide est le signe de serveurs sains et permet à Google de récupérer plus de contenu avec le même nombre de connexions. À l’inverse, un nombre significatif de codes 5xx ou de délais d’attente ralentit l’exploration.
De plus, la documentation Google cite l’optimisation du temps de réponse serveur et la mise en cache HTTP parmi les bonnes pratiques.
Pour vous, l’intérêt dépasse le robot. Un visiteur mobile qui attend quatre secondes devant votre page « Dépannage urgent » raccroche et appelle le concurrent suivant.
Trois vérifications simples :
- votre hébergement répond-il vite, y compris aux heures de pointe ?
- vos images sont-elles compressées ?
- votre site a-t-il subi des pannes récentes ?
Si vous cherchez un cadre plus large, notre guide pour optimiser le SEO d’un site internet détaille les étapes dans l’ordre.
Un cas typique, pour fixer les idées
Imaginons un paysagiste dont le site compte 40 pages utiles. Après une refonte, l’ancien site laisse derrière lui 300 adresses qui redirigent en chaîne, et le nouveau génère des pages automatiques pour chaque combinaison de ville et de type d’aménagement, avec un texte quasi identique.
Dans la Search Console, 250 pages sont « explorées, actuellement non indexées » et la page « Création de jardin » stagne en deuxième page.
Le plan : supprimer les doublons, rediriger directement chaque ancienne adresse, rédiger de vrais contenus pour les trois zones qui comptent, renforcer les liens internes vers les pages de services. Ce n’est pas une affaire de budget de crawl au sens strict, mais de propreté et de qualité. C’est exactement ce que Google récompense.
Et pour l’IA ? Une exploration propre sert aussi la visibilité future
Les moteurs de réponses basés sur l’IA s’appuient eux aussi sur des pages accessibles, rapides et claires. Un site sans blocage technique est mieux placé pour y apparaître. Pour approfondir cette évolution, vous pouvez lire ce contenu pour préparer son entreprise à ChatGPT. Sur Google même, l’impact des réponses générées est analysé dans notre article sur Google SGE et le trafic organique.
Notre point de vue
Quand un dirigeant nous parle de budget de crawl, nous commençons par le rassurer : votre site n’a probablement pas ce problème-là. Google réserve cette notion aux très gros sites, et un site de couvreur ou de paysagiste est très loin de ces volumes.
Mais nous ne répondons jamais « ne vous en occupez pas ». Le même ménage technique (doublons, redirections, erreurs serveur, sitemap propre) améliore aussi l’indexation de vos pages à devis. Et une page indexée plus vite, c’est un chantier potentiel plus tôt.
Notre approche part donc du résultat : combien de demandes qualifiées votre site génère-t-il, et quelles pages freinent ce chiffre ? Nous croisons l’audit technique, le contenu et le suivi des appels. Nous nous engageons sur des résultats mesurables sous 90 jours, avec une transparence totale sur les métriques suivies.
Le SEO fonctionne comme un actif qui prend de la valeur : un socle technique sain rend chaque contenu publié ensuite plus rentable.
Aurélie
Faire vérifier l’exploration de votre site
Vous n’avez pas le temps de fouiller la Search Console, et vous n’avez pas à le faire. Notre audit SEO identifie les pages que Google n’explore pas, celles qu’il explore sans les indexer, et les erreurs techniques qui vous coûtent des demandes de devis. Vous trouverez les repères de tarifs sur notre page prix d’un audit SEO.
Si vous voulez ensuite passer à l’action, notre programme SEO clé en main est publié de 1 000 à 10 000 € par mois selon l’ampleur du chantier. Il couvre le référencement naturel, le SEO local et le suivi des résultats. Pour démarrer par un diagnostic gratuit, rendez-vous sur branderizing.com.
FAQ
Le budget de crawl a-t-il un impact sur le référencement d’un petit site ?
Très rarement. Google situe le sujet autour de sites de plus d’un million de pages, ou de plus de 10 000 pages mises à jour chaque jour. Pour un site de PME, l’enjeu est plutôt la qualité des pages et leur indexation.
Comment augmenter le budget d’exploration de mon site ?
Vous agissez sur deux fronts : la capacité du serveur (hébergement rapide, peu d’erreurs 5xx) et l’intérêt de Google pour vos pages (contenus utiles, mis à jour, bien reliés entre eux). Supprimer les URL inutiles aide aussi, car Google se concentre sur l’essentiel.
Quelle différence entre exploration et indexation ?
L’exploration est la visite de la page par Googlebot. L’indexation est son enregistrement dans la base de Google, qui lui permet d’apparaître dans les résultats. Une page peut être explorée sans être indexée si Google la juge peu utile ou en double d’une autre.
Faut-il bloquer des pages avec robots.txt ou avec noindex ?
Pour économiser l’exploration, Google recommande robots.txt pour les URL sans importance. La balise noindex retire une page de l’index mais le robot doit quand même la visiter. Faites valider toute modification de robots.txt par un spécialiste, car une erreur peut bloquer des pages stratégiques.
Où voir ce que Googlebot explore sur mon site ?
Dans la Search Console, rapport « Statistiques sur l’exploration », dans les paramètres. Il indique les demandes, les temps de réponse et les erreurs. Google précise qu’il est surtout utile pour les sites de plus de 1 000 pages ; le rapport « Indexation des pages » est plus parlant pour un petit site.
Sources
- Gestion du budget d’exploration, Google Search Central
- Rapport « Statistiques sur l’exploration », Aide Search Console
- Myths and facts about crawling, Google Crawling
- What Crawl Budget Means for Googlebot, Google Search Central Blog