Pour indexer une page nouvelle, demandez son exploration via l’outil d’inspection d’URL de la Search Console et vérifiez qu’aucune balise noindex ni aucune règle du robots.txt ne la bloque. Actualisez ensuite votre sitemap XML si vous publiez en volume, et contrôlez le rendu de la page lorsqu’elle dépend fortement de JavaScript. Ces quatre vérifications résolvent la majorité des cas de non-indexation.
En bref:
- L’indexation peut prendre de quelques jours à plusieurs semaines ; le quota quotidien de l’outil d’inspection impose de réserver les demandes aux pages prioritaires.
- Après publication, confirmez le statut HTTP 200 et une URL canonique cohérente, puis créez un lien depuis une page déjà fréquemment explorée.
- Un sitemap XML aide Google à découvrir les URL, sans imposer leur indexation ; indiquez une date de modification fiable et retirez les pages exclues.
- Une page bloquée par robots.txt ne transmet pas sa balise noindex à Google ; après une migration, redirigez les anciennes URL en 301.
- Pour une page dépendante de JavaScript, vérifiez le rendu mobile dans l’outil d’inspection : des ressources bloquées peuvent laisser Google devant une page vide.
Actions rapides à exécuter en priorité après publication
Une fois la page en ligne, l’ordre des opérations compte autant que les opérations elles-mêmes. Voici la séquence que nous recommandons pour chaque publication stratégique :
- Ouvrez l’outil d’inspection d’URL dans la Search Console et lancez une demande d’exploration pour la page concernée.
- Vérifiez le code de statut HTTP (200 attendu), l’absence de redirection parasite et la présence d’une balise canonical auto-référencée.
- Contrôlez que la page n’est pas exclue par le robots.txt et qu’aucune balise noindex ne traîne dans le code, souvent héritée d’un gabarit de staging.
- Soumettez ou actualisez le sitemap XML si vous publiez plusieurs URL le même jour.
- Ajoutez un lien interne depuis une page déjà bien indexée et fréquemment explorée, idéalement une page de catégorie ou un article à fort trafic.
Conseil de pro : vérifiez systématiquement le rendu mobile avant de demander l’indexation : une page qui s’affiche correctement sur desktop peut rester vide côté mobile si des ressources sont bloquées.
L’outil d’inspection reste soumis à un quota quotidien, ce qui justifie de le réserver aux pages à forte valeur commerciale plutôt qu’à chaque article de blog publié.
Utiliser la Search Console pour inspecter, diagnostiquer et comprendre les statuts
L’outil d’inspection d’URL fait bien plus que demander une exploration : il affiche le HTML rendu tel que Googlebot l’a interprété, signale les ressources bloquées et indique si la page est actuellement indexée ou non. C’est le point de passage obligé avant toute demande de réexamen.
Le rapport Couverture de la Search Console classe vos URL en plusieurs catégories qu’il faut apprendre à lire :
- Valide : la page est indexée et peut apparaître dans les résultats.
- Erreur : un blocage technique empêche l’indexation (404, erreur serveur, redirection en boucle).
- Exclue : la page est volontairement ou involontairement écartée (noindex, canonical vers une autre URL, contenu dupliqué).
- Valide avec avertissement : la page est indexée malgré un problème mineur signalé.
Demander une indexation via l’outil d’inspection ne garantit rien : l’exploration et l’indexation peuvent prendre de quelques jours à plusieurs semaines selon la santé générale du site. Une page sur un domaine peu exploré attendra plus longtemps qu’une page sur un site déjà bien établi.
Concrètement, une page e-commerce en statut « Exclue, dupliquée par Google sans canonical sélectionné par l’utilisateur » signale presque toujours une fiche produit trop proche d’une variante existante. Une page en « Erreur serveur (5xx) » pointe vers un problème d’hébergement ou de charge au moment du crawl, pas vers un souci de contenu.
Sitemaps et envoi en masse : bonnes pratiques et erreurs à éviter
Le sitemap XML ne force pas l’indexation : il accélère la découverte en indiquant à Google quelles URL existent et quand elles ont été modifiées. Pour un site qui publie plusieurs pages par semaine, c’est souvent plus efficace que des demandes manuelles répétées.
- Incluez la balise
lastmodavec une date fiable : Google s’en sert pour prioriser le réexplorage des pages récemment modifiées. - Limitez chaque fichier à un nombre raisonnable d’URL et segmentez par type de contenu (produits, articles, catégories) pour un diagnostic plus fin dans la Search Console.
- Surveillez régulièrement les erreurs de sitemap signalées dans l’outil : URL bloquées par robots.txt, redirections incluses par erreur, ou balises noindex présentes alors que l’URL figure dans le flux.
- Retirez du sitemap toute page qui ne doit pas être indexée : sa présence crée un signal contradictoire.
Un sitemap propre reste un signal de découverte, pas une promesse d’indexation. Une URL peut y figurer et rester exclue si son contenu est jugé trop proche d’une autre page ou si sa qualité éditoriale est insuffisante. C’est pour cette raison qu’un audit du référencement s’avère souvent plus rentable qu’une simple resoumission de sitemap quand les volumes de pages non indexées grimpent.
Robots.txt, balises noindex et canonisation : règles et pièges fréquents
Ces trois mécanismes se confondent souvent, alors qu’ils jouent des rôles distincts et parfois contradictoires s’ils sont mal articulés.
- Le robots.txt empêche le crawl : si une page y est bloquée, Googlebot ne la visite jamais, donc il ne peut pas non plus lire une éventuelle balise noindex placée dans son code.
- La balise noindex empêche l’indexation, mais seulement si le robot peut effectivement crawler la page pour la lire. Une page bloquée par robots.txt et marquée noindex peut rester listée sans description dans les résultats, un piège classique après une migration bâclée.
- La balise rel=“canonical” indique une préférence, pas un ordre : Google peut choisir une autre URL comme version canonique en fonction de signaux comme le protocole HTTPS, les redirections en place ou la présence dans le sitemap.
- Après une migration ou une fusion de contenus proches, vérifiez que les anciennes URL redirigent en 301 vers la bonne cible plutôt que de compter uniquement sur le canonical, qui met parfois plusieurs semaines à être pris en compte.
L’erreur la plus fréquente que nous observons reste la combinaison robots.txt bloqué et noindex ajouté « pour être sûr », qui produit l’effet inverse de celui recherché.
Rendu JavaScript et indexation mobile-first : vérifier que le contenu est visible
Le parcours technique d’une page suit trois étapes : le crawl, le rendu, puis l’indexation. Google explore d’abord le HTML brut, met la page en file d’attente pour le rendu en headless Chromium, puis indexe le résultat obtenu après exécution du JavaScript. Ce rendu prend du temps et peut retarder l’indexation de plusieurs jours par rapport à une page en HTML statique.
- Utilisez l’outil d’inspection d’URL pour visualiser le HTML rendu tel que Googlebot le voit, pas seulement le code source.
- Le test de résultats enrichis permet de vérifier que les données structurées survivent au rendu.
- Le rendu côté serveur ou le prerendering devient nécessaire quand le contenu principal (texte, liens, balises) n’apparaît qu’après exécution d’un script côté client.
- Une page qui paraît complète en local peut rester vide pour Google si des ressources JavaScript sont bloquées par le robots.txt ou chargées depuis un domaine tiers non accessible.
Conseil de pro : comparez toujours le HTML rendu affiché dans l’outil d’inspection avec ce que vous voyez dans votre navigateur : un écart révèle presque toujours un problème de rendu côté Google.
Gérer le budget de crawl et la découverte des pages via le maillage interne
Le budget de crawl devient un sujet concret sur les sites volumineux, notamment les catalogues e-commerce de plusieurs milliers de références, où Google doit répartir son attention entre un grand nombre d’URL.
- Priorisez les liens internes depuis des pages déjà fortement explorées (catégories, pages d’accueil de rubrique) vers les nouvelles pages à faire indexer rapidement.
- Mettez à jour régulièrement des pages existantes à fort trafic : cela stimule un réexplorage plus fréquent de la zone du site concernée.
- Sur les sites à grand volume, concentrer les sitemaps et le maillage interne vers les pages à forte conversion optimise le rendement du budget de crawl plutôt que de le diluer sur des pages secondaires.
- Vérifiez que votre structure de pagination ne crée pas de boucles de crawl inutiles qui consomment le budget sans bénéfice d’indexation.
Un signal externe raisonnable, comme un lien naturel depuis un site tiers déjà exploré par Google, peut accélérer la découverte initiale, mais il ne remplace jamais une structure interne cohérente.
Diagnostiquer un état « découverte, actuellement non indexée » et corriger par priorité
Ce statut signifie que Google connaît l’existence de la page mais n’a pas jugé utile de l’explorer ou de l’indexer pour l’instant. C’est souvent un signal de priorisation plutôt qu’un blocage technique strict.
- Vérifiez d’abord les bases techniques : absence de noindex, accès autorisé dans le robots.txt, code de statut 200 confirmé dans l’outil d’inspection.
- Contrôlez la balise canonical : si elle pointe ailleurs, Google suit cette préférence et n’indexera jamais la page sous sa propre URL.
- Évaluez la qualité éditoriale de la page : un contenu trop mince ou trop proche d’une page existante reçoit rarement la priorité d’indexation.
- Renforcez le maillage interne vers la page concernée depuis des URL à forte autorité interne.
- Si plusieurs dizaines de pages partagent ce statut simultanément, le problème dépasse le cas individuel : c’est le signe qu’un audit technique complet est nécessaire plutôt qu’une correction page par page.
Une page produit isolée en « découverte, non indexée » se corrige souvent en quelques jours après enrichissement du contenu. Un lot de cent pages dans le même statut relève d’un problème structurel : architecture du site, budget de crawl insuffisant ou qualité éditoriale homogène trop faible.
Délais réalistes et quotas : combien de temps attendre avant l’indexation
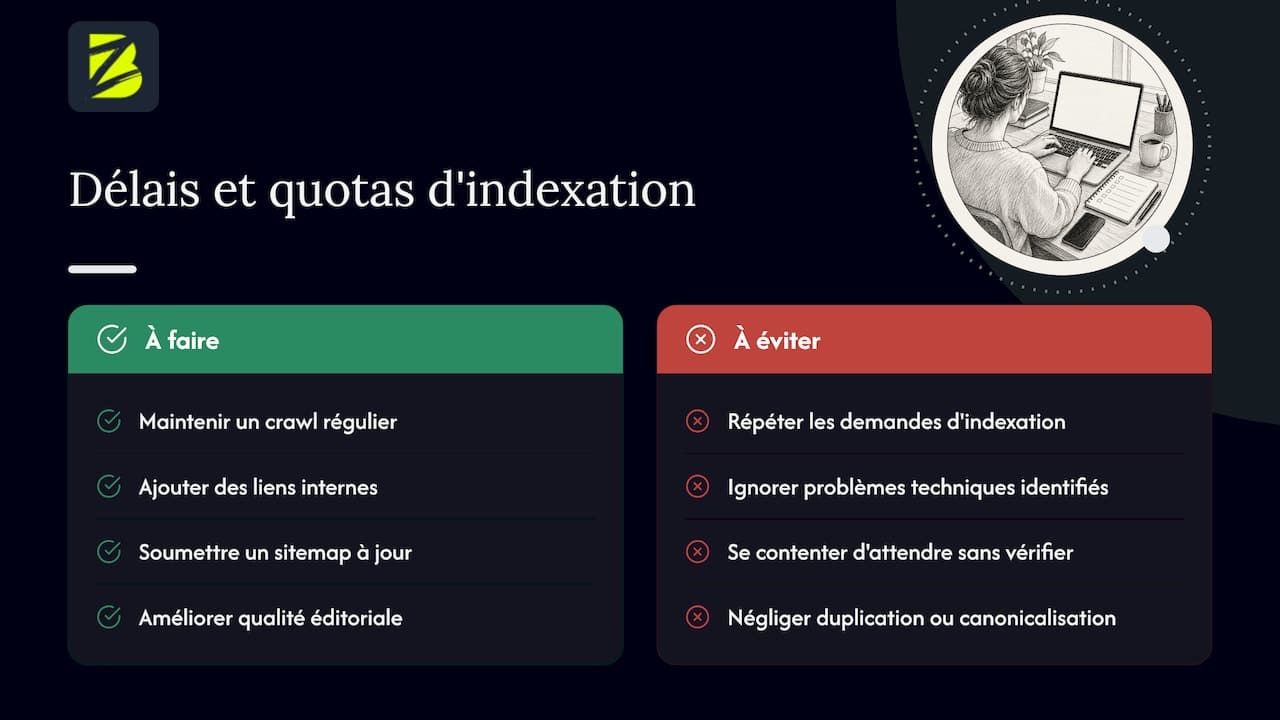
L’indexation d’une nouvelle page prend généralement de quelques jours à plusieurs semaines, selon la santé du site et la priorité accordée à la page. Un domaine déjà bien établi, avec un historique d’exploration régulier, voit souvent ses pages indexées plus vite qu’un site récent ou peu actif.
Plusieurs facteurs accélèrent le processus : l’autorité générale du domaine, la densité de liens internes vers la page, la présence dans un sitemap à jour et la qualité éditoriale perçue. À l’inverse, une demande répétée via l’outil d’inspection n’accélère rien au-delà du quota disponible : insister ne remplace pas la correction du problème sous-jacent.
Si une page reste non indexée après plusieurs semaines malgré des vérifications techniques propres, suspectez un contenu dupliqué ou une canonicalisation mal orientée plutôt qu’un simple délai à attendre.
Checklist opérationnelle 30 jours pour accélérer l’indexation des nouvelles pages
Structurer l’effort sur trente jours évite de disperser les actions et permet de mesurer ce qui fonctionne réellement.
| Période | Actions prioritaires | Indicateur à surveiller |
|---|---|---|
| — | Contrôles techniques (statut HTTP, noindex, robots.txt) et demande d’inspection pour les pages prioritaires | Statut dans l’outil d’inspection d’URL |
| — | Correction des erreurs détectées, renforcement du maillage interne, surveillance du rapport Couverture | Évolution du nombre de pages en erreur ou exclues |
| — | Enrichissement du contenu, vérification de la canonicalisation, nouvelle demande si nécessaire | Passage en statut « Valide » et apparition des premières impressions |
Au-delà de trente jours sans amélioration, le problème n’est généralement plus une question de délai mais de structure : contenu trop proche d’une page existante, budget de crawl mal orienté, ou workflow de mise en ligne qui laisse passer des erreurs techniques à chaque publication.
Ce que nous observons chez nos clients sur les blocages d’indexation
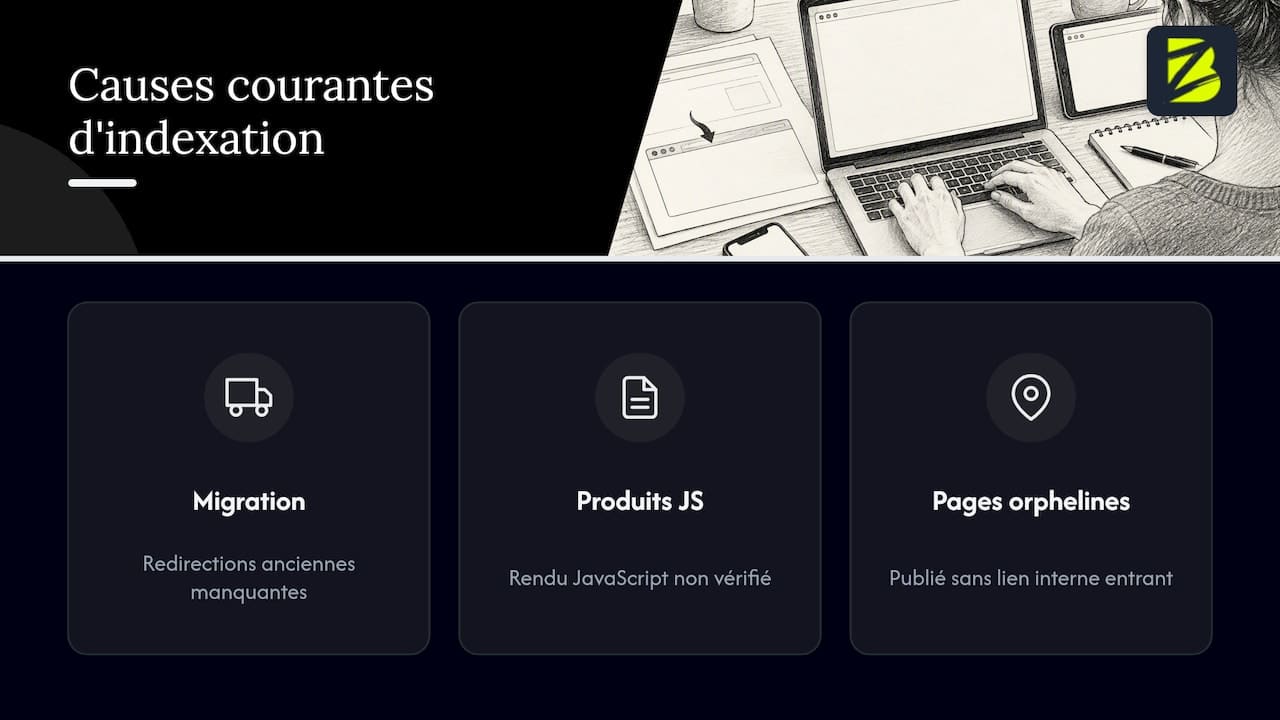
Les cas les plus fréquents que nous rencontrons se répartissent en trois familles assez nettes : les migrations de site où d’anciennes redirections manquent, les fiches produits générées dynamiquement en JavaScript sans rendu vérifié, et les pages orphelines publiées sans aucun lien interne entrant.
L’erreur la plus coûteuse reste la confiance aveugle dans le sitemap seul, sans contrôle du rendu ni du maillage. Une page peut y figurer depuis des semaines sans jamais être explorée, simplement parce qu’aucun lien interne ne la signale comme prioritaire.
Nous recommandons une action ponctuelle (demande d’inspection, correction de balise) quand le problème touche une poignée de pages isolées. Un audit complet devient pertinent dès qu’un pattern se répète sur plusieurs dizaines d’URL, signe d’un problème structurel plutôt que d’un incident isolé.
— Aurélie
Comment nous accompagnons la résolution des blocages d’indexation
Quand l’indexation cale malgré les corrections de base, nous intervenons avec un diagnostic qui va chercher la cause réelle plutôt que de multiplier les demandes d’inspection sans effet. Notre audit SEO complet couvre le rendu JavaScript, la structure du sitemap, le maillage interne et la canonicalisation, avec un plan d’action priorisé à la clé.
Concrètement, notre accompagnement se décompose en trois volets selon vos besoins :
- Un diagnostic technique complet qui identifie les pages bloquées, exclues ou mal canonicalisées et classe les corrections par impact attendu.
- Une correction du rendu JavaScript et de la configuration des sitemaps pour les sites où le contenu dynamique freine l’indexation.
- Un pilotage continu via notre programme SEO clé en main, qui inclut le suivi du rapport Couverture et l’ajustement du maillage interne dans la durée.
Notre positionnement garantit des résultats mesurables sous 90 jours, faute de quoi nous poursuivons l’accompagnement sans coût supplémentaire jusqu’à l’atteinte des objectifs fixés. Si vous préférez commencer par un diagnostic ciblé, demandez un audit technique afin d’identifier la source du blocage.
Questions fréquentes
Comment demander l’indexation d’une page sur Google ?
Utilisez l’outil d’inspection d’URL dans la Search Console : saisissez l’adresse de la page, laissez l’outil l’analyser, puis cliquez sur « Demander une indexation ». Pour un grand nombre d’URL, soumettre un sitemap XML à jour reste plus efficace que des demandes manuelles répétées.
Comment mettre en index ?
Mettre une page en index suppose d’abord qu’elle soit explorable : aucune balise noindex, aucun blocage dans le robots.txt, et un code de statut 200 confirmé. Une fois ces conditions réunies, la demande d’exploration via la Search Console ou la présence dans un sitemap accélère la découverte, sans garantir un délai fixe.
C’est quoi le SEO et SEA ?
Le SEO désigne l’ensemble des techniques qui améliorent la visibilité d’un site dans les résultats naturels des moteurs de recherche, sans paiement direct par clic. Le SEA correspond aux campagnes publicitaires payantes, comme Google Ads, où chaque clic sur une annonce est facturé.
Qu’est-ce qu’un index d’un livre ?
Dans l’édition, un index de livre est une liste alphabétique des termes ou sujets traités, avec renvoi aux pages correspondantes, pensée pour la recherche manuelle par le lecteur. L’index d’un moteur de recherche fonctionne sur un principe proche mais à l’échelle du web : une base de pages cataloguées que l’algorithme interroge pour répondre à une requête.
Pourquoi une page reste-t-elle en « découverte, non indexée » ?
Ce statut signifie que Google connaît l’URL mais n’a pas encore priorisé son exploration ou son indexation, souvent faute de liens internes suffisants ou en raison d’un contenu jugé trop proche d’une page existante. Renforcer le maillage interne et enrichir le contenu accélère généralement la résolution.
Sources
- Request indexing | Google Search Central (support)
- Search Console start guide | Google Search Central